Fiabilité, redondance et causes communes d’une base martienne
FAIT / MESURÉINGÉNIERIESCÉNARIO EXPLICITE
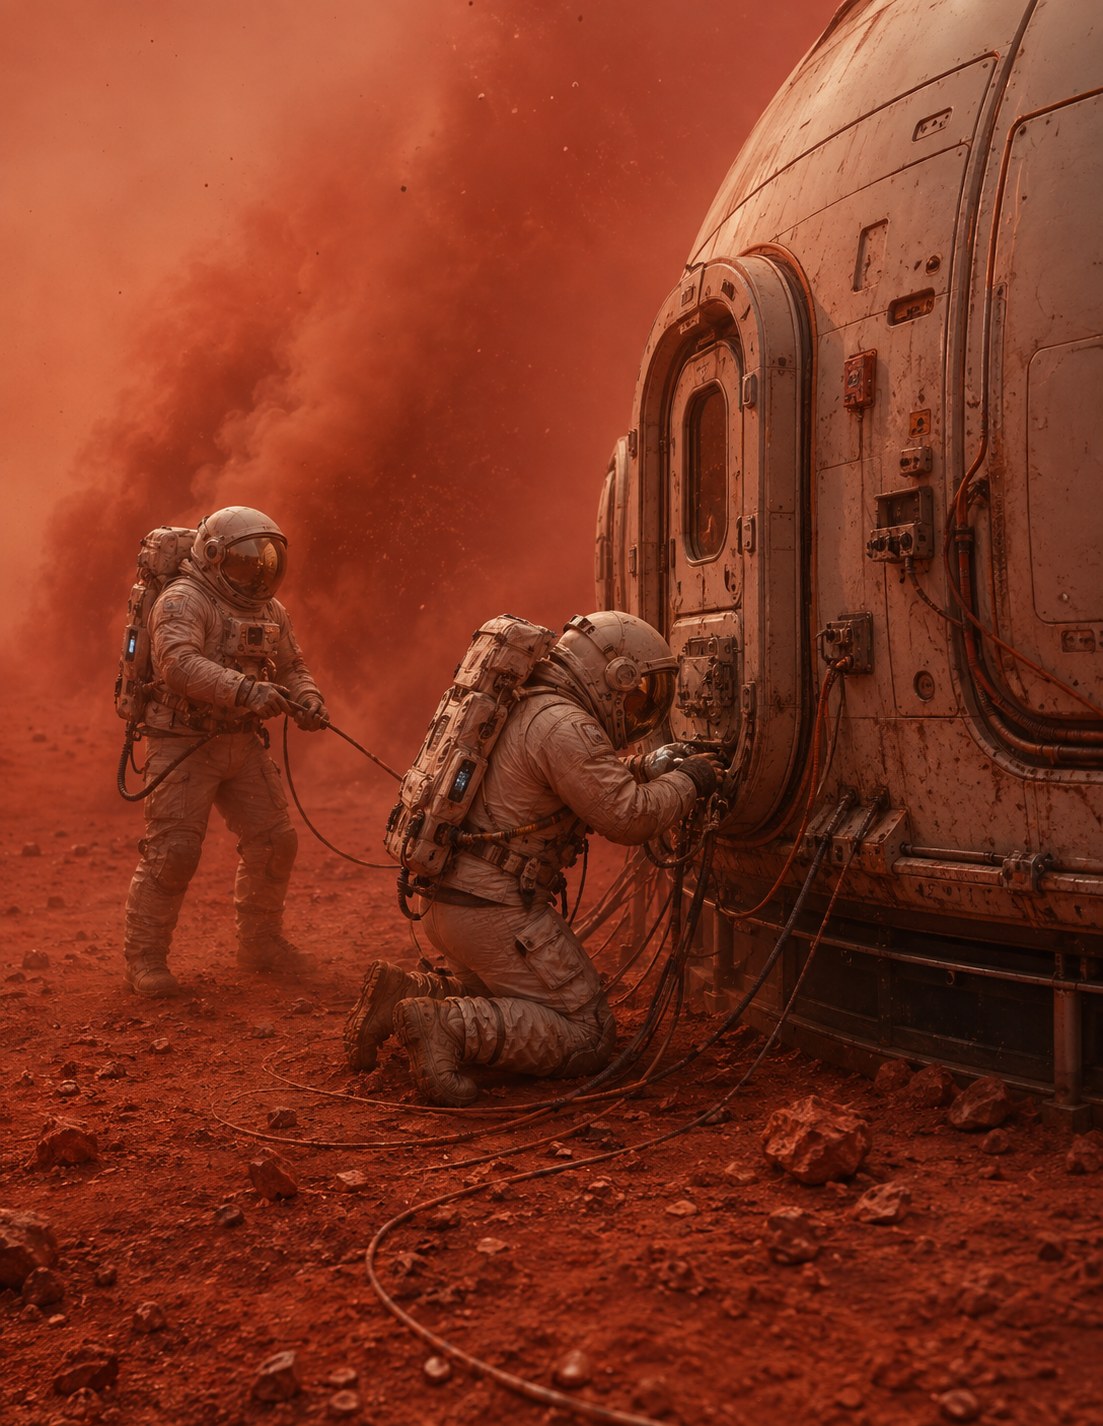
Visualisation conceptuelle d’un mode dégradé : une panne peut coïncider avec un environnement défavorable. La fiabilité réelle doit donc traiter les causes communes — poussière, alimentation, température, accès EVA, erreur humaine — et pas seulement additionner des composants redondants.
Pourquoi deux équipements identiques ne donnent pas toujours deux fois plus de sûreté
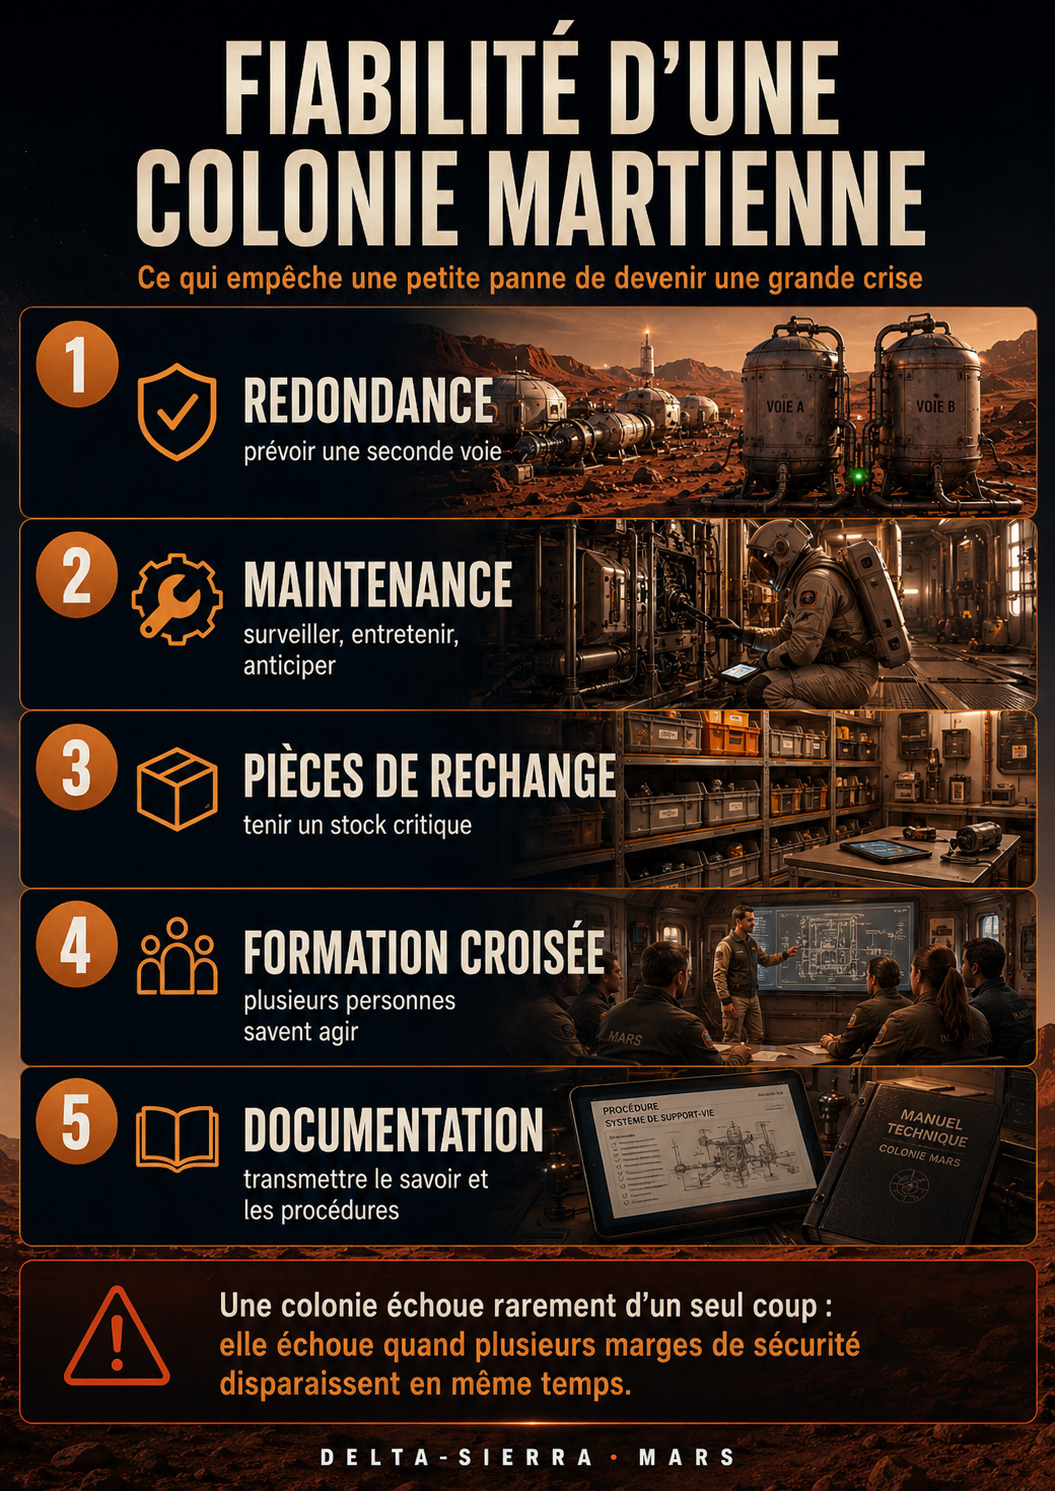
La fiabilité d’une base martienne ne se résume pas au nombre d’équipements de secours. Une fonction vitale reste réellement disponible seulement si ses moyens de secours ne partagent pas la même alimentation, le même logiciel, le même refroidissement, les mêmes capteurs ou la même erreur de maintenance.
L’analyse commence donc par les fonctions dont la perte mettrait l’équipage ou la mission en danger : énergie, support-vie, contrôle thermique, communications, calcul, détection et maintenance. Pour chacune, il faut identifier les dépendances communes avant de compter les voies redondantes.
Les indicateurs utiles sont le taux de panne, la disponibilité, le temps de réparation, la couverture de détection et l’état des pièces de rechange. Ils ne doivent pas être lus séparément : un équipement très fiable mais impossible à diagnostiquer ou à réparer peut être moins utile qu’un équipement un peu moins fiable dont la panne est détectée et récupérée rapidement.
Pour deux voies réellement indépendantes, une combinaison parallèle peut réduire la probabilité de perdre la fonction. Cette relation cesse d’être représentative dès qu’une cause commune peut atteindre les deux voies. C’est pourquoi les disciplines de Reliability & Maintainability de la NASA traitent ensemble fiabilité, maintenabilité, indépendance et preuve de fonctionnement.
La redondance n’est utile que si les chaînes de défaillance sont séparées
Un refuge n’est utile que s’il reste indépendant des défaillances du volume principal : énergie, communication, air et accès doivent éviter les mêmes causes communes.
Deux équipements identiques ne constituent pas automatiquement une architecture tolérante aux pannes. Ils peuvent partager le même logiciel, le même convertisseur électrique, le même circuit de refroidissement, le même lot de fabrication ou la même procédure de maintenance. Une analyse de cause commune cherche précisément ces dépendances. Pour une fonction vitale, il faut savoir quelles ressources restent indépendantes après incendie, perte d’un bus, erreur de mise à jour ou contamination d’un stock. La séparation peut être physique, électrique, logicielle, organisationnelle ou temporelle selon le mécanisme de panne.
La fiabilité utile à Mars est donc orientée mission. Une fonction peut être indisponible quelques heures sans menacer l’équipage si un refuge ou une capacité réduite existe, alors qu’une autre exige une continuité quasi immédiate. Les allocations de fiabilité, les temps de réparation et les stocks doivent être convertis en scénarios : que reste-t-il après la première panne, quelle seconde panne devient alors critique et combien de temps l’équipage possède-t-il pour retrouver une configuration sûre ?
Des symptômes à la cause commune : diagnostiquer ce qui tombe ensemble
Une arborescence de diagnostic pour Fiabilité, redondance et causes communes d’une base martienne indique quelles observations éliminent chaque hypothèse.
Redondance, diversité et séparation physique : choisir ce qui protège vraiment
éviter la redondance de façade : diversité, séparation et réparation peuvent valoir davantage qu’un simple doublage
FMEA/FMECA, analyse arbres de défaillance, tests de panne, données de durée et suivi des causes communes
Pour Fiabilité, redondance et causes communes d’une base martienne, chaque essai déclare sa configuration, son environnement, son instrumentation et son critère de réussite.
Le journal de bord conserve la configuration exacte et les tendances des variables taux de panne, disponibilité, dépendances, couverture de détection, temps réparation, stock rechanges et modes communs. Chaque incident réévalue les seuils de détection, la diversité des redondances, les composants critiques à stocker et les scénarios d’entraînement ;
Mesurer la fiabilité d’une base qui doit survivre sans dépannage terrestre
Les indicateurs de fiabilité n’ont de sens que s’ils sont reliés aux conséquences pour l’équipage et au temps réellement disponible pour réagir. Une indisponibilité de quelques minutes peut être acceptable pour une fonction secondaire et devenir critique pour le support-vie, le refroidissement ou l’alimentation électrique.
Chaque fonction dépend aussi d’autres systèmes : énergie, logiciel, capteurs, communications, refroidissement, pièces de rechange et compétences de maintenance. L’analyse doit donc suivre ces dépendances jusqu’aux points où plusieurs voies supposées indépendantes peuvent en réalité tomber ensemble.
Concevoir la défaillance : la fiabilité martienne commence quand on cesse d’imaginer la panne unique
La redondance est souvent résumée par une image rassurante : si une pompe tombe en panne, la seconde prend le relais. Mais deux pompes identiques peuvent partager le même logiciel, la même alimentation, le même lot de joints, le même fluide contaminé ou la même erreur de maintenance. La vraie question n’est donc pas « combien d’exemplaires ? », mais « quelles causes peuvent les faire tomber ensemble ? ».
La cause commune est l’ennemi invisible de N+1
Une architecture N+1 signifie qu’un besoin nominal de N unités dispose d’une unité supplémentaire. Cette stratégie protège bien contre certaines pannes indépendantes, mais beaucoup moins contre une cause commune. La diversité peut alors être plus utile que la duplication : capteurs de principes différents, alimentations séparées, logiciels ou chaînes de mesure indépendantes, séparation physique contre incendie ou inondation locale.
La diversité possède cependant un coût. Deux technologies différentes demandent deux stocks, deux formations et deux méthodes de diagnostic. La bonne architecture cherche donc le point où la diversité réduit un risque de cause commune sans rendre la maintenance impossible. C’est un arbitrage de système, pas un slogan de sûreté.
Fiabilité, disponibilité et maintenabilité ne sont pas synonymes
Un équipement peut tomber rarement mais rester indisponible longtemps faute de pièce ; un autre peut tomber souvent mais être réparé en quelques minutes. Pour une base, la disponibilité dépend donc à la fois de la fréquence des défaillances et du temps de restauration. La NASA a développé des méthodes de maintenabilité et d’analyse des rechanges précisément parce que les missions lointaines ne peuvent pas compter sur le paradigme de réapprovisionnement fréquent de l’ISS.
La métrique utile doit suivre la fonction. Pour l’air respirable, quelques minutes d’indisponibilité peuvent être graves ; pour une imprimante 3D secondaire, plusieurs jours peuvent être acceptables. La criticité détermine le niveau de redondance, de stock et de surveillance.
Une base doit savoir se dégrader avec élégance
La robustesse ne signifie pas maintenir toutes les fonctions à pleine puissance pendant toute crise. Une ville martienne doit savoir délester : ralentir une usine, suspendre des expériences, réduire le chauffage d’un volume inoccupé, immobiliser certains véhicules et concentrer les ressources sur les fonctions vitales. Ce « graceful degradation » évite qu’une tentative de sauver tout le système provoque une panne générale.
Le plan doit être écrit avant l’incident. Quel seuil déclenche le délestage ? Quelle autorité décide ? Quel service redémarre en premier ? Comment vérifier que la récupération n’introduit pas une nouvelle panne ? Ces décisions lient fiabilité, opérations et gouvernance.
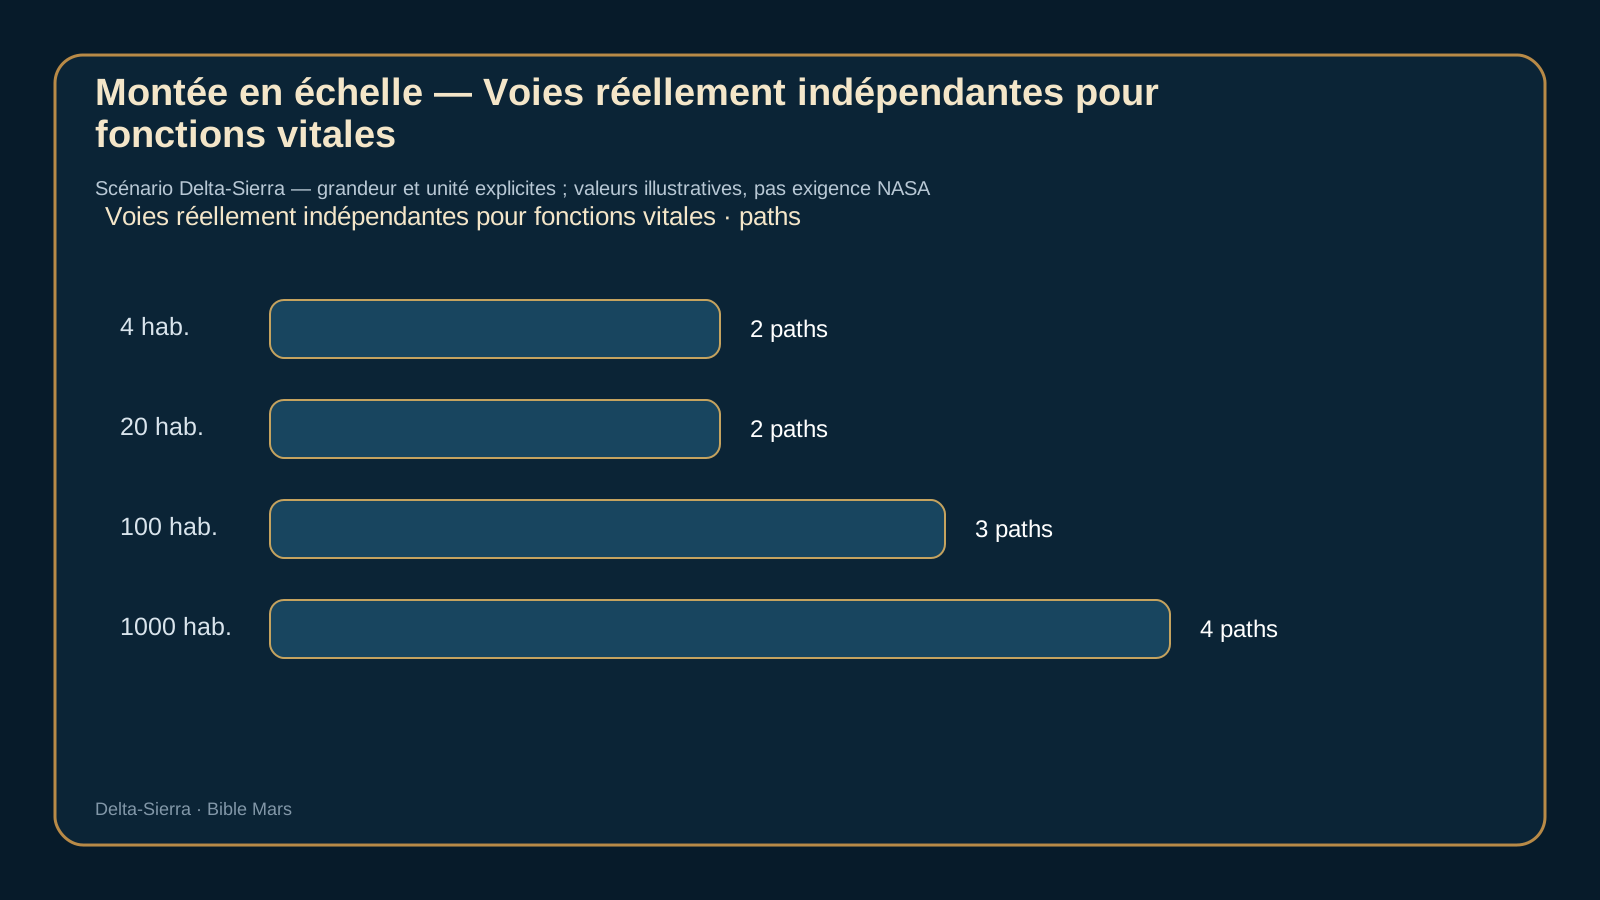
De quatre à mille habitants : la redondance devient géographique
À quatre personnes, beaucoup de redondance tient dans un habitat compact. À vingt, plusieurs modules permettent déjà une séparation physique. À cent, il devient raisonnable de distribuer certains stocks, ateliers et moyens de production. À mille, une seule centrale, un seul réservoir ou un seul centre de contrôle crée une concentration de risque difficile à justifier. La fiabilité devient alors une question d’urbanisme : quartiers, boucles, vannes d’isolement, réserves locales et capacité de fonctionner en îlots.
La meilleure preuve de maturité n’est pas un chiffre de disponibilité affiché sur une brochure. C’est un catalogue de scénarios où la base peut expliquer ce qui tombe, ce qui reste disponible, ce qui est réparé, avec quelles pièces, par qui et en combien de temps.
Tester la récupération est plus important que tester seulement la panne
Beaucoup d’essais vérifient qu’un système détecte une faute et bascule sur un secours. Mais la récupération possède ses propres risques : une vanne restée fermée, un logiciel dont la configuration n’est pas resynchronisée, un réservoir presque vide après l’incident. Le test complet doit donc aller jusqu’au retour à un état durable. Une base qui sait survivre trente minutes mais pas reconstituer ses marges n’est pas réellement résiliente.
Les exercices doivent aussi varier les hypothèses. Une panne franche est souvent plus facile à diagnostiquer qu’un capteur biaisé, une fuite lente ou un composant intermittent. Les scénarios « ambigus » sont ceux qui entraînent réellement l’organisation à chercher la cause plutôt qu’à appliquer une recette.
La fiabilité humaine doit être conçue sans chercher un opérateur parfait
Étiquetage, ergonomie, procédures, éclairage, alarmes et outils peuvent réduire la probabilité d’une erreur. C’est plus robuste que d’exiger une vigilance héroïque permanente. La philosophie doit être la même que pour le matériel : supposer que l’erreur arrivera, empêcher qu’elle se propage, la détecter rapidement et rendre le retour en arrière possible.
Monographie approfondie
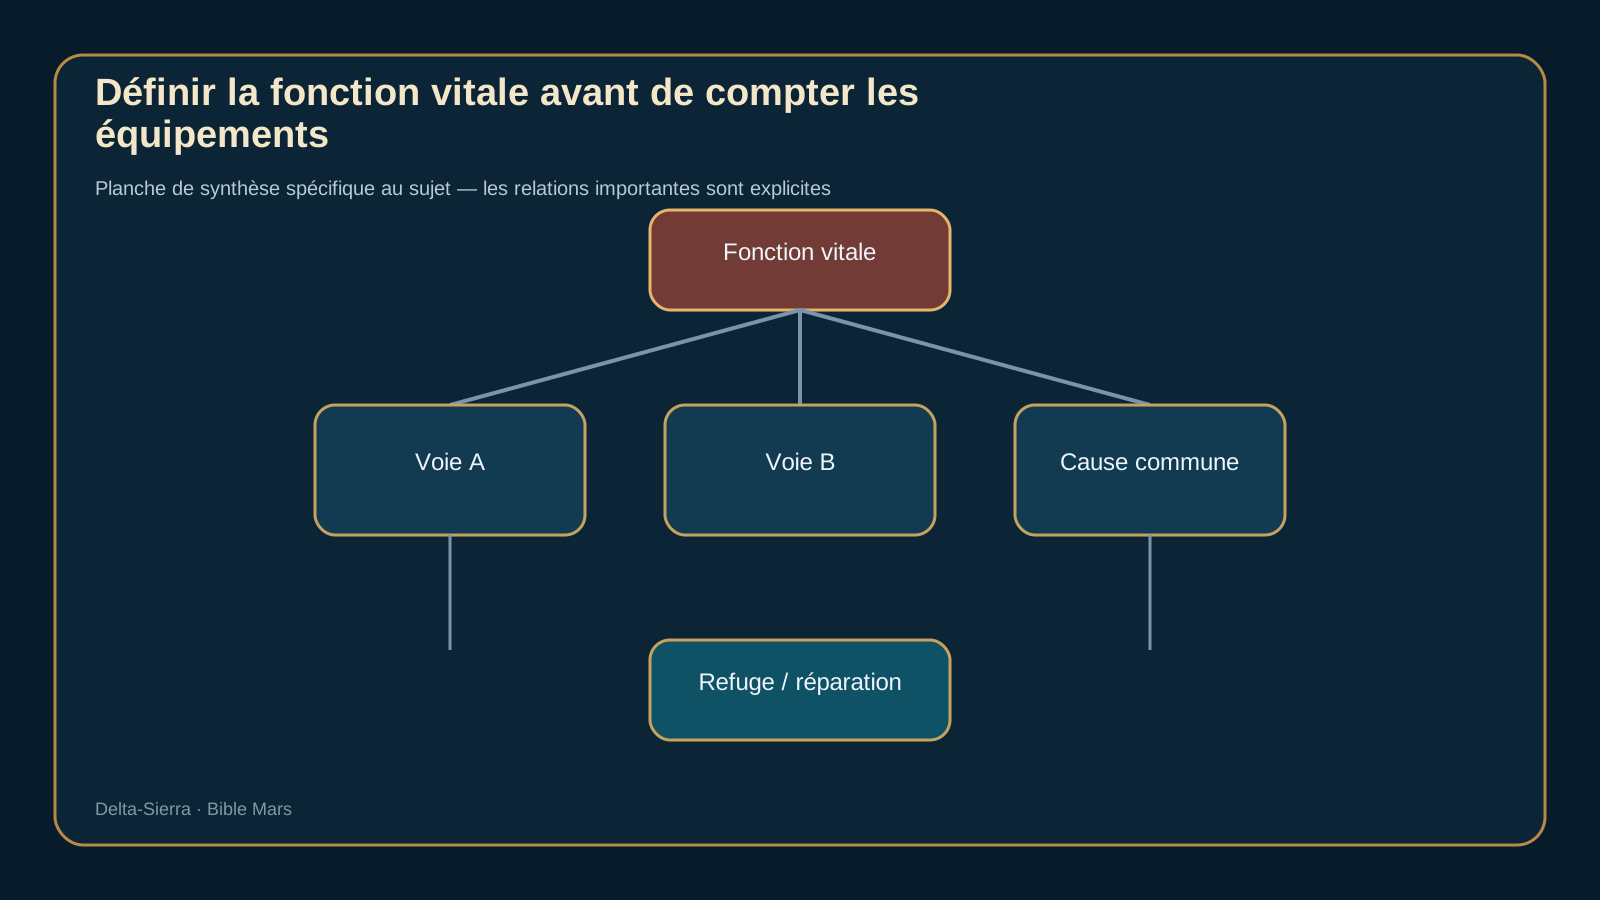
Définir la fonction vitale avant de compter les équipements
Une redondance n’a de valeur que par rapport à une fonction précise — alimenter, refroidir, mesurer, pressuriser ou contrôler — et aux dépendances qui peuvent faire tomber plusieurs voies en même temps.
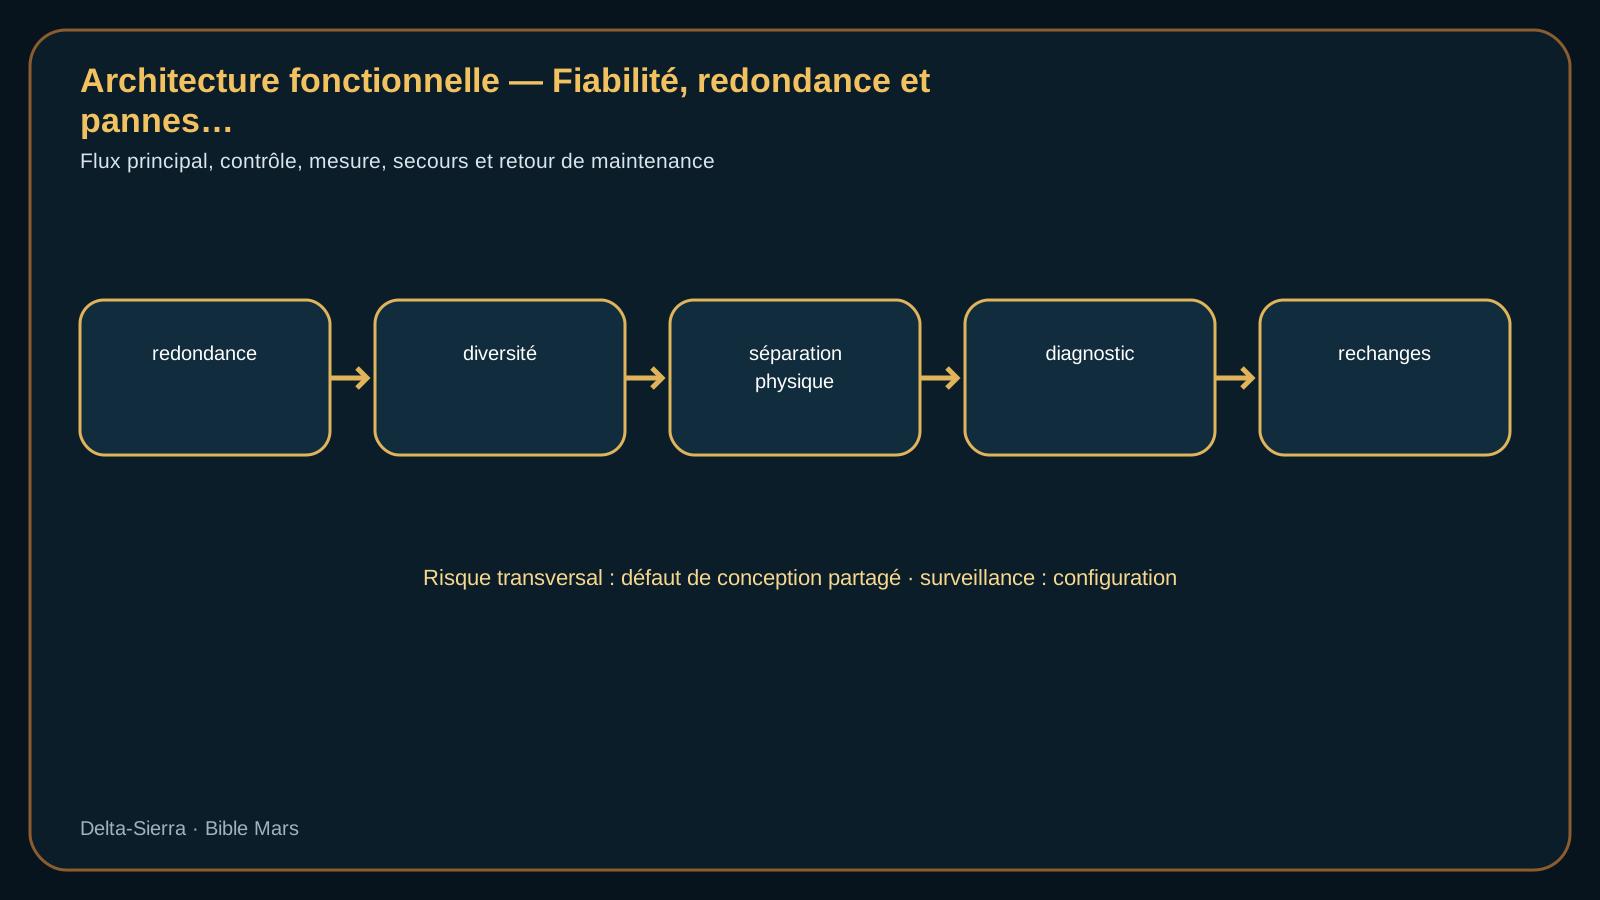
Schéma niveau A : flux fonctionnel principal ; les détails et limites sont explicités dans le texte.Planche niveau B : représentation conçue pour ce sujet, sans prétendre remplacer les données et hypothèses du texte.
Pourquoi la probabilité n’est pas la fiabilité vécue par un équipage isolé
Une valeur calculée n’aide l’équipage que si elle correspond à la configuration réellement exploitée. Après une réparation ou le remplacement d’un élément redondant, il faut donc contrôler la pièce, effectuer un essai fonctionnel et enregistrer la nouvelle configuration avant de déclarer la fonction de nouveau disponible. Pour les fonctions critiques, séparer autant que possible la personne qui réalise l’intervention de celle qui autorise la remise en service réduit le risque de reproduire ou de masquer une erreur de maintenance. L’autonomie martienne suppose enfin que ces diagnostics et ces essais puissent être réalisés localement, sans attendre une conversation synchrone avec la Terre.
Redondance active, froide, chaude et fonctionnelle
Une architecture robuste doit aussi survivre à la combinaison de plusieurs événements ordinaires. Un lot de composants défectueux peut être découvert pendant qu’une voie est déjà en maintenance ou qu’une équipe est en EVA ; la ressource de secours devient alors concurrente d’autres besoins en énergie, communication et personnel. Les exercices doivent donc combiner les pannes et vérifier que la diversité prévue est réelle : deux voies de fabricants, de technologies ou de logiciels différents doivent réagir suffisamment différemment pour qu’une même cause ne les rende pas indisponibles au même moment. Pendant le diagnostic, la procédure doit également préciser la fonction minimale à maintenir et les critères permettant de distinguer, par exemple, une surtension d’un défaut de lot.
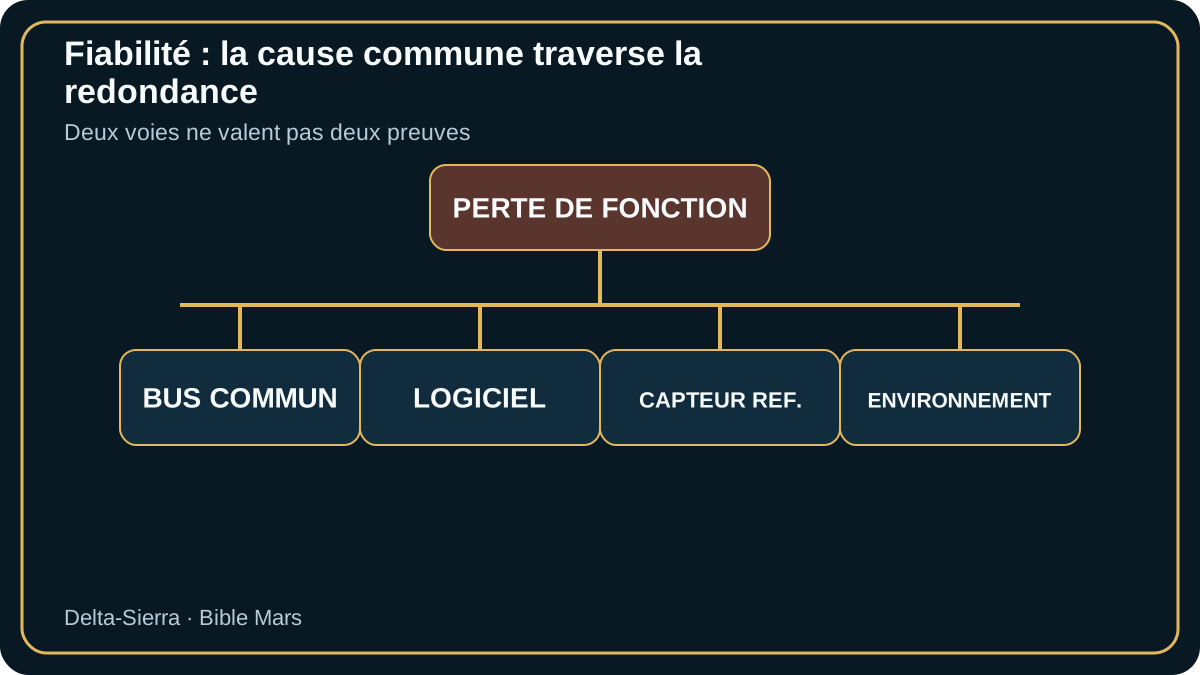
Cause commune : le défaut qui traverse les duplications
Séparation électrique et logicielle : deux machines ne valent rien si elles partagent le même cerveau
Un contrôleur automatique peut isoler une voie, basculer vers une réserve ou arrêter un procédé plus vite qu’un humain, mais il ne doit pas pouvoir transformer une mesure erronée en panne commune. La logique de commande doit donc distinguer les actions réversibles des actions dangereuses et prévoir les cas où une confirmation humaine reste nécessaire. Les essais doivent injecter des capteurs faux mais plausibles, des données contradictoires et des pannes simultanées afin de vérifier que le système se replie vers un état compréhensible. La séparation doit être évaluée jusqu’aux alimentations, réseaux, logiciels, capteurs et procédures de maintenance réellement partagés.
Disponibilité et réparabilité : combien de temps le service existe-t-il vraiment ?
MTBF : un indicateur utile qui ne prédit pas la date de la prochaine panne
Le MTBF, ou temps moyen entre pannes, décrit une tendance statistique ; il ne prédit pas la date de la prochaine défaillance. Pour être utile, il doit être complété par la qualité des mesures, la capacité de détecter une dérive et les conséquences d’une erreur de diagnostic. Une mesure trop imprécise peut masquer une dégradation ; une exigence de précision excessive peut au contraire consommer inutilement du temps, des étalons et des pièces. La métrologie doit donc être dimensionnée à partir de la décision à prendre et de la marge de sûreté nécessaire. À l’échelle d’une colonie, cela conduit aussi à organiser clairement qui confirme l’anomalie, qui décide d’un arrêt préventif et quelles fonctions peuvent être temporairement délestées pendant l’investigation.
Fiabilité du système : séries, parallèles et fonctions minimales
Diagnostic faux : quand le système remplace une bonne pièce et conserve la mauvaise
Un faux diagnostic peut dégrader une architecture redondante plus sûrement qu’une panne franche : l’équipe retire le canal sain, conserve le canal défaillant et réduit elle-même sa marge. La première défense est donc une arborescence d’hypothèses qui sépare défaut du composant, défaut du capteur, erreur de câblage, lot commun, surtension, contamination et erreur de maintenance. Chaque branche doit posséder au moins un observable indépendant ; deux capteurs issus du même calculateur ne constituent pas deux preuves indépendantes.
Le diagnostic doit également préserver la configuration. Avant d’échanger un module, on enregistre version matérielle, version logicielle, symptômes, conditions électriques et dernier événement de maintenance. Si deux chaînes tombent ensemble, la priorité n’est pas de remplacer deux fois la même pièce mais de chercher ce qu’elles partagent : alimentation, horloge, logiciel, environnement, procédure ou lot de fabrication. La séparation physique n’a de valeur que si ces dépendances communes ont elles aussi été séparées.
Prenons une hausse simultanée d’erreurs mémoire sur deux calculateurs. Une surtension transitoire et un lot de composants fragiles peuvent produire des symptômes proches, mais les décisions sont différentes. La tension du bus, les journaux d’alimentation, la distribution des erreurs et l’historique des numéros de lot permettent de départager les hypothèses. Tant que la cause n’est pas suffisamment discriminée, la bonne stratégie consiste à maintenir un canal sous observation, limiter les reconfigurations irréversibles et préparer un essai qui puisse réellement falsifier l’une des causes proposées.
Réparabilité : la meilleure redondance est parfois une réparation profonde
Certaines pratiques issues des systèmes habités, comme le contrôle des fissures et l’inspection périodique, montrent l’intérêt de détecter une dégradation avant qu’elle ne devienne une rupture. Leur transposition à Mars doit toutefois rester prudente : durée de mission, gravité, possibilités de ravitaillement et infrastructures disponibles sont différentes. L’enjeu n’est donc pas de copier une procédure terrestre ou orbitale, mais de conserver le principe utile — surveiller l’état, diagnostiquer la cause et disposer d’un moyen crédible de restaurer la fonction — puis de le requalifier pour l’environnement martien.
Calculs reproductibles propres au sujet
Disponibilité et temps de réparation
A = MTBF/(MTBF+MTTR) ; 1 000/(1 000+20)=98,04 % ; avec MTTR=5 h → 99,50 %
À MTBF identique, réduire le temps moyen de réparation de vingt à cinq heures augmente fortement la disponibilité. Sur Mars, l’accès, l’outillage et le diagnostic peuvent donc être aussi importants que la durée de vie intrinsèque.
Trois éléments en série
Rsys = 0,99³ = 0,9703
Si trois fonctions indépendantes sont toutes indispensables et ont chacune une fiabilité de mission de 0,99, la chaîne complète tombe à environ 0,970. Ajouter des éléments en série peut réduire la fiabilité globale même si chaque élément paraît très fiable.
Deux voies parallèles idéalisées
R = 1 − (1 − 0,95)² = 0,9975
Le gain spectaculaire n’existe que si les deux voies échouent indépendamment. Un logiciel partagé, un lot de pièces identique ou une alimentation commune peut réintroduire une cause commune qui invalide ce calcul optimiste.
Faire entrer rechanges et maintenance dans le calcul de fiabilité
Rechanges : masse transportée contre risque résiduel
Le système livré au premier équipage possède une configuration connue ; après plusieurs années, une même fonction peut réunir une pièce réusinée localement, un capteur d’une autre série, une procédure corrigée et un réglage différent. Sans historique de configuration, les statistiques de panne et les hypothèses de séparation deviennent rapidement fictives. Il faut donc relier chaque intervention aux mesures d’état, aux inspections, aux essais réalisés et aux critères de remise en service. Cette traçabilité est particulièrement importante pour distinguer une cause commune logicielle d’une mauvaise procédure de maintenance répétée sur plusieurs équipements.
Rechanges : masse transportée contre risque résiduel. La réparabilité se décide en grande partie avant la panne. Accès aux organes, connecteurs standardisés, outillage, possibilités de nettoyage, points de levage et procédure d’essai après remontage déterminent si une pièce de rechange peut réellement restaurer le service. Une base autonome doit pouvoir diagnostiquer la panne, isoler l’équipement, effectuer la réparation puis prouver localement que la configuration remise en service est correcte.
Essais accélérés : révéler les défauts avant le départ sans créer une illusion de certitude
Les essais accélérés peuvent révéler des mécanismes d’usure avant le départ, mais ils ne reproduisent jamais parfaitement des années d’exploitation martienne. Après une défaillance ou une erreur de maintenance, la remise en service doit donc suivre une séquence vérifiable : comprendre la cause, rechercher les dommages secondaires, contrôler la configuration, effectuer un essai fonctionnel progressif puis surveiller le système renforcé pendant une période définie. Le retour d’expérience des systèmes habités montre l’intérêt de cette discipline ; sur Mars, elle devra aussi intégrer le vieillissement après de nombreux cycles, les réparations locales et les changements de version logicielle ou matérielle.
Quatre habitants : peu de techniciens, forte dépendance à la simplicité
Vingt habitants : spécialisation et premier véritable atelier de fiabilité
À vingt habitants, la maintenance commence à se spécialiser : certaines personnes peuvent suivre les tendances de panne, préparer les essais et tenir à jour les configurations sans que toute l’expertise repose sur un seul pionnier. À mesure que la colonie grandit, cette fonction devient un véritable service technique. Les campagnes d’essai doivent alors reproduire des situations qui distinguent les mécanismes de défaillance — par exemple un défaut de lot, une panne indépendante ou une erreur de maintenance — et vérifier ce qui reste disponible pendant le diagnostic. Le but est de conserver une capacité minimale sûre tout en identifiant la cause, et non de réussir seulement un essai nominal.
Mille habitants : autorité technique, certification et statistiques de terrain
Graphique de scénario : la grandeur, l’unité et le statut illustratif sont affichés ; les valeurs ne sont pas des exigences NASA.
Deux pompes identiques, un même lot de joints
Deux pompes identiques, un même lot de joints. Deux voies physiques séparées tombent en panne à quelques heures d’intervalle parce qu’elles utilisent le même lot de joints. Le calcul de redondance indépendante était donc faux. Le scénario impose de tracer lots, fournisseurs, logiciels, environnements et procédures communes.
Une réparation plus rapide vaut une redondance
Une réparation plus rapide vaut une redondance. Une architecture simple avec accès excellent peut rester plus disponible qu’une architecture double impossible à réparer. Le scénario compare temps moyen de réparation, stock de pièces et perte de fonction afin de décider où investir la masse : deuxième machine ou atelier capable de remise en état rapide.
Le logiciel commun neutralise la duplication
Le logiciel commun neutralise la duplication. Deux calculateurs différents exécutent la même logique fautive et prennent ensemble la mauvaise décision. Le scénario rappelle que la diversité doit parfois porter sur l’algorithme, les données ou la chaîne de validation, pas seulement sur le boîtier.
Une panne catastrophique rarissime
Une panne catastrophique rarissime. Un mode de défaillance très improbable détruirait plusieurs fonctions vitales à la fois. Sa probabilité seule ne suffit pas à le négliger si la conséquence est irréversible. Le scénario force à comparer prévention, séparation physique, refuge et capacité de récupération.
Du modèle probabiliste à une architecture testable sur Mars
Scénario de double panne : rechercher la cause partagée avant de consommer le dernier secours
Lorsqu’une seconde panne survient, l’équipage doit d’abord vérifier si les deux événements ont une cause commune avant de consommer le dernier moyen de secours. Cette compétence ne peut pas dépendre d’un expert unique : les données de configuration, les mesures d’état, l’historique de maintenance et les critères de remise en service doivent permettre à plusieurs opérateurs de reconstruire la situation. Après des années d’exploitation et de réparations locales, la redondance réelle doit être réévaluée à partir de l’état du matériel et des pièces disponibles, pas de l’architecture telle qu’elle existait au départ.
Concevoir pour l’inconnu : marges, interfaces standard et accès physique
La fiabilité d’une ville : passer du matériel spatial à une culture industrielle du retour d’expérience
La redondance n’améliore la fiabilité que si les pannes sont suffisamment indépendantes
Deux pompes en parallèle peuvent sembler deux fois plus rassurantes qu’une. Pourtant, si elles partagent la même alimentation, le même logiciel, le même lot de joints ou la même poussière d’admission, une seule cause peut les arrêter ensemble. La fiabilité martienne doit donc distinguer la multiplicité physique et l’indépendance des causes.
Pour deux composants identiques indépendants de fiabilité R sur une mission donnée, une redondance parallèle « au moins un fonctionne » donne Rp = 1 − (1 − R)². Si R = 0,95, Rp = 1 − 0,05² = 0,9975. Cette amélioration spectaculaire disparaît si les deux composants partagent une probabilité significative de défaillance commune.
Calcul — disponibilité avec réparation
Une approximation classique de la disponibilité intrinsèque est A = MTBF / (MTBF + MTTR). MTBF est le temps moyen entre pannes et MTTR le temps moyen de réparation. Avec MTBF = 1 000 h et MTTR = 10 h, A ≈ 1 000/1 010 = 0,9901, soit 99,01 %. Réduire MTTR à 2 h donne environ 99,80 %. Sur Mars, l’accès, les outils et les pièces peuvent donc augmenter la disponibilité autant qu’une amélioration du composant lui-même.
La cause commune doit devenir une variable explicite du modèle
Les analyses FMEA/FMECA étudient les modes de défaillance et leurs effets ; les arbres de panne — FTA — partent d’un événement redouté et remontent vers des causes combinées ; les Reliability Block Diagrams représentent la logique de succès du système. Aucun outil n’est suffisant seul. Une cause commune peut contourner une belle structure « deux sur trois » si elle attaque les trois voies.
Une approche pratique consiste à classer les dépendances : énergie commune, refroidissement commun, logiciel commun, environnement commun, maintenance commune et origine industrielle commune. La diversité peut être une barrière : technologies différentes, alimentations séparées, implémentations logicielles indépendantes ou procédures de test distinctes. Elle ajoute toutefois de la complexité de formation et de pièces.
La fiabilité est donc un compromis entre homogénéité et diversité. Des équipements identiques facilitent les rechanges et l’apprentissage ; des équipements différents réduisent certaines causes communes. Une base martienne doit décider où la standardisation est plus précieuse et où la diversité protège une fonction vitale.
La maintenabilité transforme une probabilité de panne en durée de perte de service
Un système inévitablement imparfait peut rester très disponible si la panne est détectée rapidement, l’accès simple, la pièce disponible et la requalification courte. À l’inverse, un composant très fiable mais enfermé derrière quinze heures de démontage peut devenir un goulet d’étranglement. La conception doit donc suivre le temps depuis le premier symptôme jusqu’à la preuve de remise en service.
Ce temps se décompose : détection, diagnostic, mise en sécurité, accès, démontage, réparation/remplacement, remontage, calibration, test fonctionnel et surveillance renforcée. Chacune de ces étapes peut être préparée par des connecteurs accessibles, des points de test, des outils, une documentation claire et des pièces standardisées.
Quatre causes communes à simuler avant de parler de « N+1 »
Un défaut logiciel identique est déployé sur toutes les voies
Trois calculateurs identiques exécutent la même erreur. La redondance matérielle ne protège pas. Il faut un rollback, une version sûre ou une diversité de fonctions critiques.
La poussière colmate simultanément plusieurs prises
Des filtres séparés peuvent partager le même environnement. La barrière devient la séparation physique, la possibilité d’isoler une branche et la capacité de nettoyage.
Un lot de composants possède le même défaut latent
Les rechanges stockés peuvent partager le défaut des unités installées. La traçabilité de lot et la diversification des stocks deviennent des outils de fiabilité.
Une erreur de maintenance est reproduite sur les systèmes redondants
Une procédure ambiguë ou un mauvais outil peut introduire la même panne dans deux voies lors d’une campagne. Des contrôles croisés et une requalification indépendante peuvent devenir plus efficaces qu’un troisième équipement.
La fiabilité d’une cité doit être suivie comme un portefeuille de services vitaux
À quatre personnes, une panne peut être gérée par beaucoup d’attention humaine. À cent ou mille habitants, la base doit instrumenter tendances, backlog, taux de panne, consommation de rechanges et temps de réparation. Les indicateurs ne doivent pas être des scores décoratifs : ils doivent conduire à des décisions de stock, de redesign ou d’inspection.
La fiabilité d’une fonction comme l’air dépend de plusieurs sous-systèmes : énergie, capteurs, ventilation, épuration, vannes, logiciel et structure. Le bon niveau de décision est donc le service. Une pompe peut être hors service sans que le service soit perdu ; inversement tous les composants peuvent être « verts » alors qu’une interface commune empêche la fonction.
NASA Safety and Mission Assurance maintient une discipline Reliability & Maintainability et le standard actif NASA-STD-8729.1A. Delta-Sierra s’en sert comme cadre méthodologique pour rappeler que la fiabilité englobe analyses de modes de panne, maintenabilité, causes communes et preuve de service — pas comme une garantie chiffrée appliquée automatiquement à une base martienne.
Schéma de synthèse spécifique au chapitre.
Étude de cas — ne pas confondre redondance nominale et indépendance
Cinq fonctions en série ayant chacune R_i = 0,99 donnent R_série = ∏R_i = 0,99⁵ ≈ 0,951. R_i est la fiabilité de chaque fonction sur l’intervalle et R_série celle de la chaîne complète. Des éléments individuellement à 99 % ne donnent donc qu’environ 95,1 % lorsque toute la chaîne est nécessaire.
Deux pompes peuvent partager alimentation, logiciel, fluide contaminé ou procédure. Une cause commune contourne le calcul naïf de deux défaillances indépendantes.
FMEA, arbres de défaillance et essais de bascule doivent démontrer que la voie de secours ne dépend pas du défaut initial et que la réparation est faisable avec les moyens présents.
Cas de décision — deux trains redondants tombent ensemble : panne double ou cause commune ?
Deux chaînes de traitement d’air supposées redondantes déclenchent presque simultanément une alarme de débit. Remplacer deux ventilateurs serait une réaction intuitive mais potentiellement fausse. Avant toute intervention, on recherche ce que les chaînes partagent : alimentation, horloge, version logicielle, capteur de référence, procédure de calibration, lot de filtres et environnement thermique. Une panne commune peut être invisible dans un schéma qui ne montre que les équipements fonctionnels.
La stratégie de diagnostic doit créer de l’indépendance dans la mesure. Une alimentation d’essai séparée, une lecture locale hors réseau, un capteur de référence portable ou le chargement temporaire d’une version logicielle connue permettent de tester les dépendances une par une. Si les deux trains retrouvent un débit normal avec une référence indépendante, la redondance matérielle n’était pas le problème : c’était la dépendance cachée.
Le retour d’expérience modifie alors l’architecture. On peut séparer physiquement une alimentation, diversifier un capteur, décaler les opérations de maintenance ou conserver une version logicielle de secours. La fiabilité utile n’est donc pas le nombre d’équipements installés mais la probabilité que le service vital survive aux événements plausibles, y compris ceux qui traversent plusieurs branches à la fois.
NASA NTRS — Common Cause Failures Dominate and Defeat Redundancy — Cette étude est intégrée au cœur de la distinction entre redondance et indépendance. Deux équipements identiques ne protègent pas contre une même erreur de conception, un même environnement ou une même procédure de maintenance ; la diversité et la séparation des causes deviennent des variables d’architecture.
NASA NTRS — Limitations of Reliability for Long-Endurance Human Spaceflight — Le document est utilisé pour expliquer pourquoi extrapoler une probabilité de succès depuis une mission courte vers plusieurs années peut donner une illusion de précision. La disponibilité martienne doit combiner fiabilité, réparation, rechanges, diagnostic et reconfiguration.
NASA NTRS — Supportability Concepts for Crewed Deep Space Exploration — La supportabilité complète la fiabilité : un système peut tomber en panne et rester acceptable si la détection, l’accès, la compétence, l’outillage et le rechange existent. La page s’en sert pour déplacer l’objectif de « ne jamais tomber en panne » vers « continuer à fournir le service ».
Sources et résultats documentaires
Définir la fonction vitale avant de compter les équipements : les références ci-dessous sont retenues parce qu’elles apportent un résultat, un statut technologique ou un cadre de vérification directement utile au sujet.
NASA Standards — Safety, Quality, Reliability, Maintainability
Le catalogue NASA regroupe notamment les normes R&M, métrologie, assurance des composants EEE, câblage et logiciel. Pour une industrie martienne, la qualité ne peut donc pas être séparée de la traçabilité des procédés et de la configuration.
La seconde mission CHAPEA a commencé le 19 octobre 2025 pour 378 jours avec quatre volontaires. NASA y simule notamment ressources limitées, isolement prolongé, délai de communication pouvant atteindre 22 minutes et défaillances d’équipements : un analogue utile pour observer charge de travail et autonomie décisionnelle.